Как устроить безопасную среду для разработки и внедрения ИИ
Искусственный интеллект постепенно переходит из экспериментальных лабораторий в рабочие процессы компаний. Вместе с этим меняется и подход к инфраструктуре: отдельного сервера с моделью уже недостаточно. Организации нужен управляемый контур, в котором можно готовить данные, обучать и тестировать модели, подключать их к приложениям и контролировать результат после запуска.
Безопасность такой среды нельзя добавлять в самом конце. Она должна быть заложена в архитектуру, правила доступа, движение данных и процесс выпуска новых версий. Тогда разработчики сохраняют удобный темп работы, а владельцы систем понимают, кто и на каком основании использует вычислительные ресурсы и информацию.
Из каких компонентов складывается ИИ-среда
Практический контур обычно включает хранилища исходных и подготовленных данных, вычислительные узлы, инструменты разработки, реестр моделей, средства развёртывания и наблюдаемости. Эти части должны работать согласованно. Если команда переносит файлы вручную, запускает обучение из случайных окружений и хранит версии без единого реестра, воспроизводимость быстро теряется.
Поэтому архитектуру полезно строить вокруг понятного жизненного цикла. Данные поступают через контролируемые каналы, проходят проверку и подготовку, модель получает версию и описание параметров, а выпуск в рабочую среду выполняется по утверждённому сценарию. Каждый этап оставляет след, который можно проверить при разборе ошибки или инцидента.
Единый контур вместо набора разрозненных инструментов
Интеграция особенно важна для команд, где одновременно работают специалисты по данным, разработчики приложений, инженеры инфраструктуры и информационной безопасности. Им нужны разные интерфейсы, но общие правила. Решение класса «экосистема решений для безопасного создания ии-среды» помогает рассматривать подготовку, эксплуатацию и защиту ИИ не как отдельные проекты, а как связанные части одного процесса.
При выборе платформы стоит оценивать не только количество доступных функций. Важнее понять, поддерживает ли она существующие форматы данных и модели, позволяет ли разграничивать полномочия, фиксирует ли историю изменений и встраивается ли в корпоративные системы разработки. Чем меньше ручных переходов между этапами, тем ниже риск потерять важный параметр или использовать неподтверждённую версию.
Как защитить данные и вычислительные ресурсы
Первый уровень защиты — минимально необходимые права. Пользователь или сервис получает доступ только к тем наборам данных, моделям и операциям, которые нужны для конкретной задачи. Отдельные роли следует предусмотреть для разработки, проверки, публикации и администрирования. Это снижает вероятность случайного изменения рабочего контура и упрощает аудит.
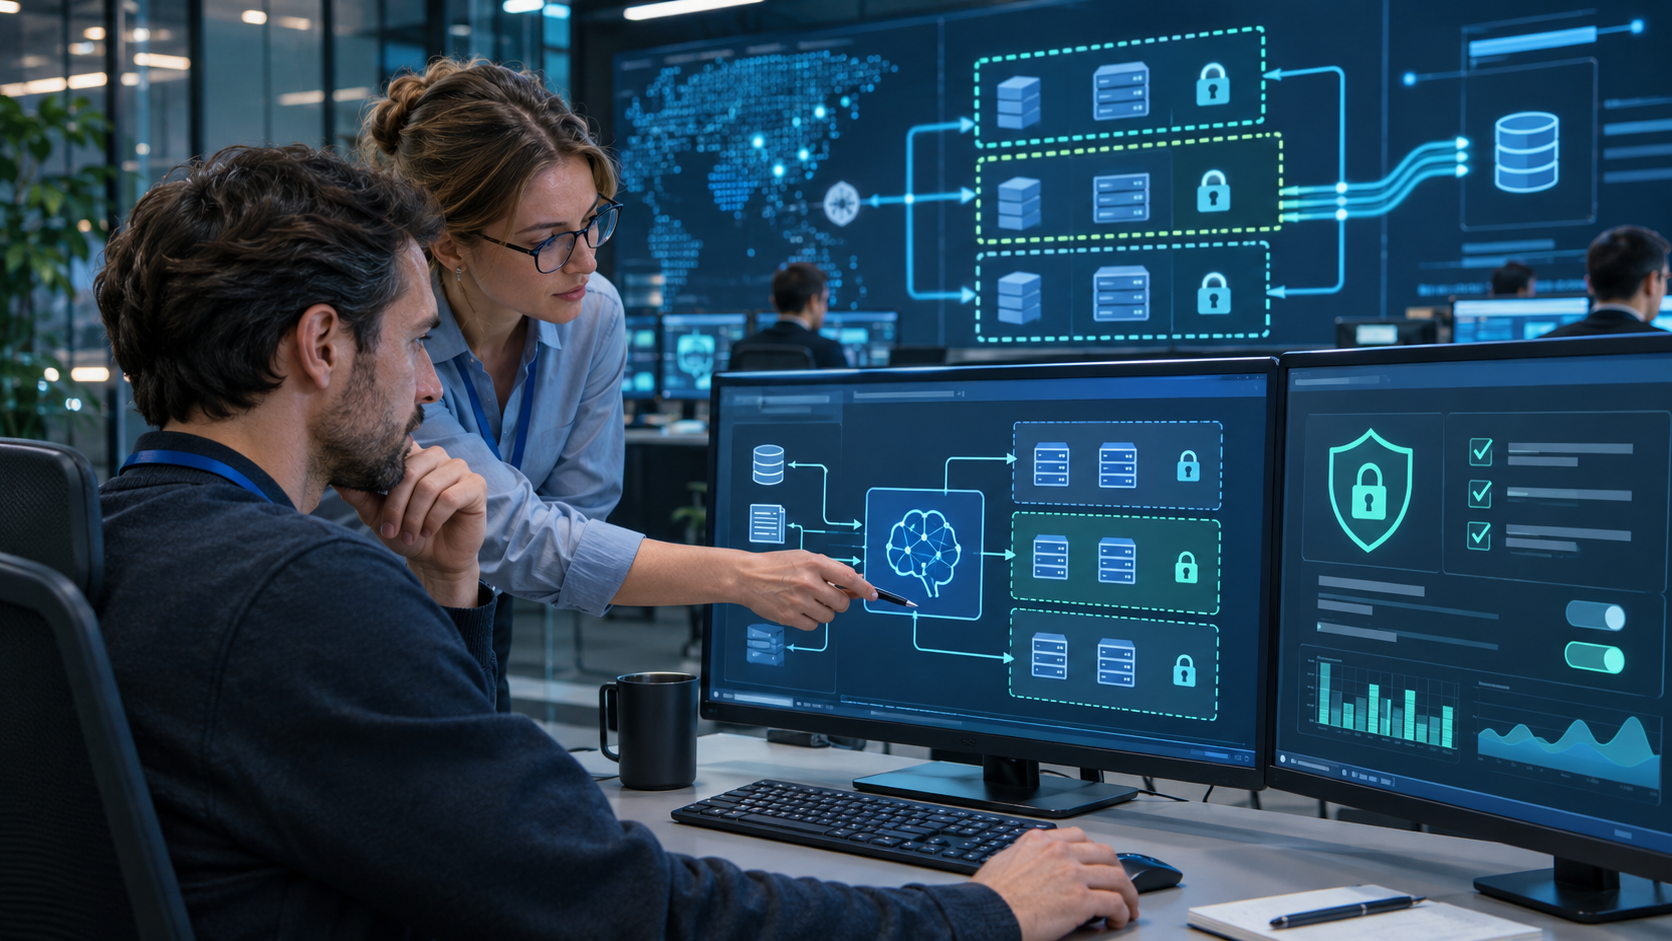
Не менее важно разделять среды. Эксперимент с новым кодом не должен влиять на систему, которой уже пользуются сотрудники или клиенты. Изолированные проекты, лимиты ресурсов и сетевые политики позволяют проводить исследования без неконтролируемого доступа к соседним сервисам. Чувствительные данные при этом защищают при хранении и передаче, а секреты не размещают непосредственно в коде и блокнотах.
Воспроизводимость и контроль версий
Результат модели зависит не только от её кода. На него влияют версия данных, параметры обучения, библиотеки, аппаратная конфигурация и порядок обработки. Чтобы эксперимент можно было повторить, эти сведения нужно связывать в одну запись. Такой паспорт помогает сравнивать варианты и не допускать случайной публикации модели, которая не прошла проверку.
Для рабочего выпуска полезен формальный шлюз: автоматические тесты, проверка качества, оценка ограничений и подтверждение ответственного специалиста. После одобрения модель переносится тем же воспроизводимым способом, которым собиралась тестовая версия. Ручная настройка непосредственно в продуктивной среде должна быть исключением и обязательно фиксироваться.
Наблюдаемость после запуска
Даже успешно протестированная модель со временем может вести себя иначе. Меняются входные данные, пользовательские сценарии и внешние условия. Поэтому в эксплуатации отслеживают не только загрузку процессоров и время ответа, но и качество прогнозов, распределение признаков, долю ошибок и необычные запросы.
Метрики стоит связывать с конкретной версией модели и приложения. Тогда при ухудшении показателей команда быстрее определит причину и сможет откатить изменение. Журналы должны содержать достаточно информации для расследования, но не раскрывать персональные или конфиденциальные данные тем, кому они не нужны.
С чего начать внедрение
Начинать разумно с одного понятного сценария, где можно измерить результат и описать требования к данным. Команда фиксирует текущий процесс, определяет роли, выбирает метрики и строит минимальный воспроизводимый конвейер. После нескольких стабильных циклов к нему добавляют автоматизацию проверок, централизованный реестр и расширенный мониторинг.
Безопасная ИИ-среда появляется не за счёт одного защитного средства. Её формируют согласованные технические компоненты и понятные организационные правила. Когда данные проходят контролируемый путь, версии прослеживаются, полномочия ограничены, а эксплуатация наблюдаема, внедрение искусственного интеллекта становится предсказуемым и управляемым.