Как автоматизация упрощает управление кластеризированными приложениями
Кластерная архитектура помогает приложениям выдерживать рост нагрузки и продолжать работу при отказе отдельных узлов. Но вместе с устойчивостью появляется дополнительная сложность: нужно согласованно развёртывать версии, распределять ресурсы, следить за состоянием сервисов и быстро разбирать отклонения. Ручные операции в такой среде плохо масштабируются, поэтому команды всё чаще переводят повторяемые действия в управляемые автоматические процессы.
Почему кластер требует единого контура управления
Один сервис может состоять из десятков экземпляров, зависеть от баз данных, очередей сообщений, хранилищ и сетевых политик. Изменение одного компонента влияет на соседние, а локальная ошибка способна распространиться на весь контур. Единый слой управления позволяет описать желаемое состояние системы и затем сравнивать его с тем, что действительно запущено на узлах.
Такой подход уменьшает количество разрозненных команд и настроек. Вместо ручной проверки каждого сервера платформа отслеживает доступность экземпляров, распределяет нагрузку и восстанавливает сервисы по заранее заданным правилам. Инженер при этом сохраняет контроль над политиками, ограничениями и порядком изменений.
Какие процессы стоит автоматизировать в первую очередь
Наибольший эффект обычно дают операции, которые выполняются часто и должны давать одинаковый результат. К ним относятся развёртывание новой версии, масштабирование, проверка готовности, управление конфигурацией и откат. Для каждого действия полезно определить условия запуска, критерии успеха и понятный сценарий остановки при ошибке.
Командам, которые выбирают решение класса «платформа автоматизации управления кластеризированными приложениями», важно оценивать не только набор функций, но и то, как оно встраивается в существующий цикл разработки. Ценность появляется тогда, когда инструменты сборки, тестирования, развёртывания и наблюдаемости связаны в один воспроизводимый процесс.
Наблюдаемость как основа безопасной автоматизации
Автоматический сценарий не должен скрывать происходящее. Метрики, журналы событий и трассировки помогают понять, достигнуто ли требуемое состояние и на каком этапе возникло отклонение. Полезно связывать технические показатели с версиями приложения и конкретными операциями: так проще отличить инфраструктурный сбой от ошибки нового релиза.
Пороговые значения и уведомления необходимо настраивать так, чтобы они отражали реальное влияние на пользователей. Избыточное число сигналов быстро снижает внимание команды, а слишком редкие проверки задерживают реакцию. Поэтому автоматизация мониторинга начинается с небольшого набора измеримых показателей доступности, задержки и ошибок.
Масштабирование и восстановление без ручной рутины
В кластерной среде нагрузка меняется неравномерно. Политики масштабирования позволяют добавлять экземпляры при росте потребления ресурсов и сокращать их количество после спада. При этом важно учитывать время запуска приложения, лимиты инфраструктуры и зависимости, которые могут стать новым узким местом.
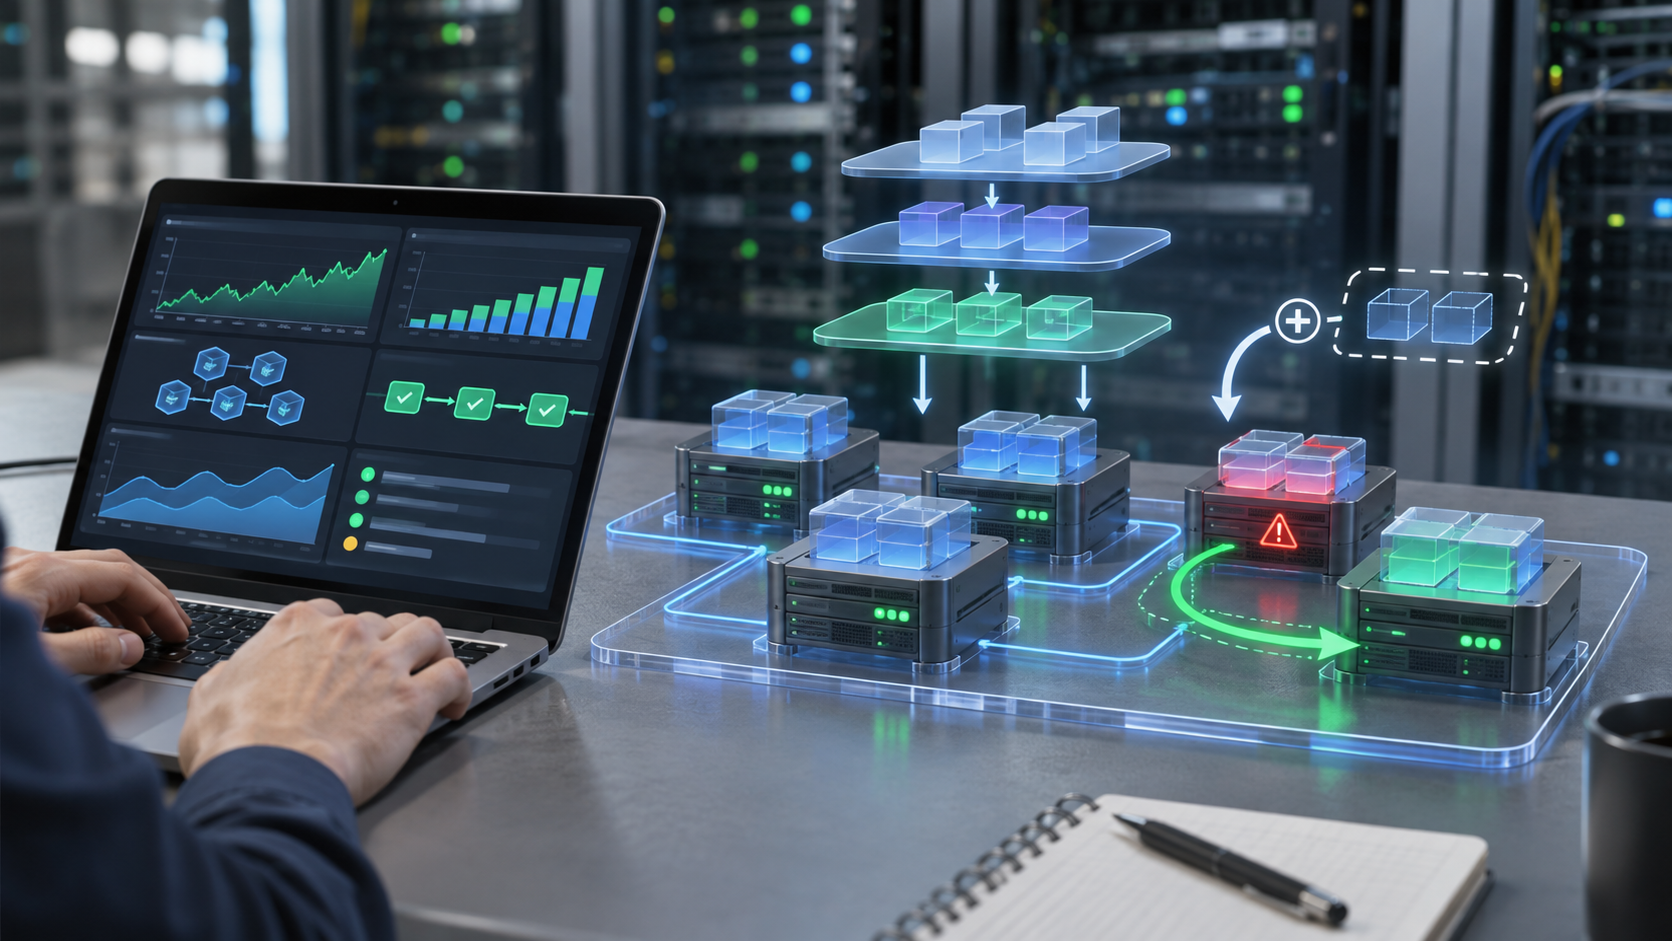
Механизмы самовосстановления работают по тому же принципу: система обнаруживает недоступный экземпляр, исключает его из обслуживания и запускает замену. Однако автоматический перезапуск не устраняет первопричину. Команда должна сохранять диагностические данные и ограничивать число повторов, чтобы постоянный цикл восстановления не маскировал устойчивую неисправность.
Как снижать риск при выпуске новых версий
Постепенное развёртывание позволяет сначала направить небольшую долю трафика на новую версию, сравнить показатели и только затем продолжить обновление. Если метрики ухудшаются, автоматический стоп или откат сокращает время воздействия ошибки. Для критичных систем полезно заранее проверять совместимость схем данных и возможность возврата к предыдущей версии.
Надёжный процесс также требует разграничения прав. Разработчикам нужны удобные типовые операции, но изменения сетевых политик, секретов и производственных ограничений должны проходить отдельный контроль. Журналирование действий помогает восстановить последовательность событий и упрощает разбор инцидентов.
Практический путь внедрения
Начинать лучше с одного приложения и ограниченного сценария, например воспроизводимого развёртывания с проверкой готовности. После нескольких стабильных циклов можно добавить автоматический откат, масштабирование и стандартизированные шаблоны для других команд. Такой порядок позволяет проверить правила на реальной нагрузке и не переносить старые ручные ошибки в новый конвейер.
Автоматизация управления кластером полезна не сама по себе, а как способ сделать изменения предсказуемыми и наблюдаемыми. Когда желаемое состояние формализовано, проверки измеримы, а действия оставляют понятный след, команда быстрее выпускает обновления и спокойнее реагирует на сбои.